
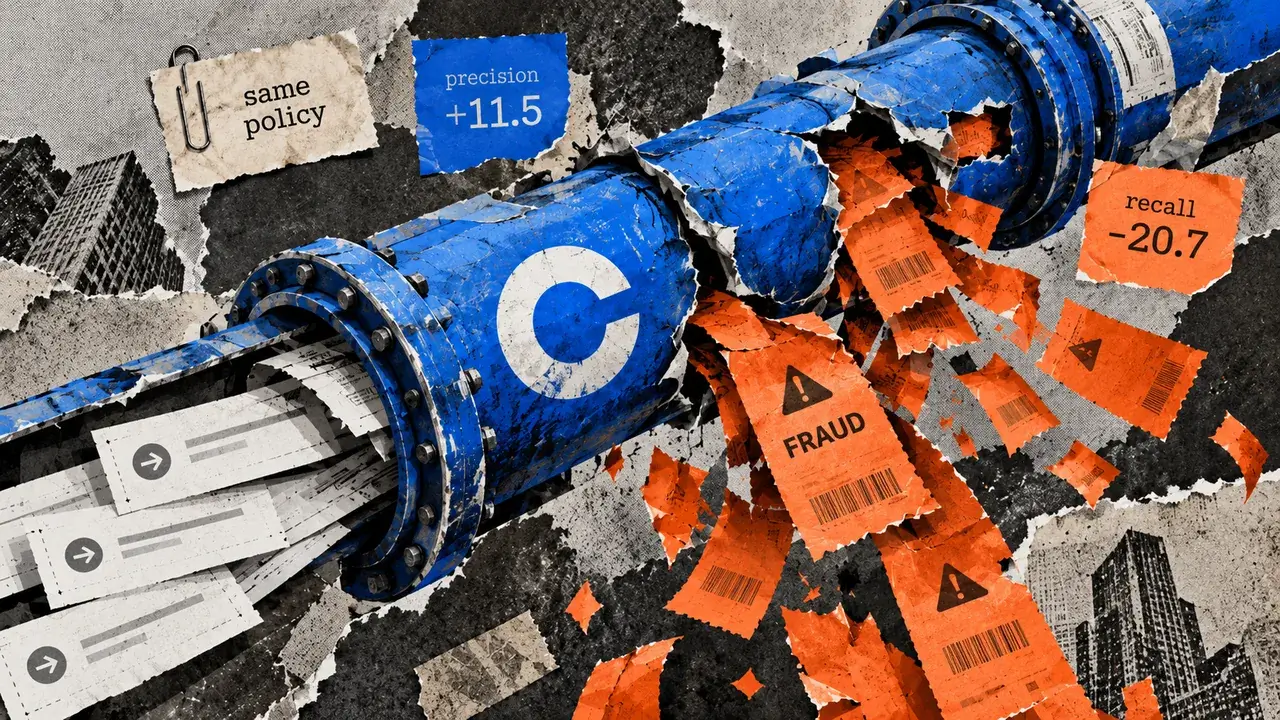
در یک بازپخش تاریخی از تراکنشهای پرداخت، نسخههای جدیدتر سه خانواده مدل هوش مصنوعی نتوانستند به اندازه نسخههای قبلی موارد کلاهبرداری و ارزش مالی آنها را شناسایی کنند. این نتیجه در حالی به دست آمد که سیاست تبدیل ارزیابی ریسک به تصمیم نهایی در کل آزمون ثابت نگه داشته شده بود؛ موضوعی که نشان میدهد ارتقای مدل بهتنهایی الزاماً عملکرد یک سامانه غربالگری پرداخت را بهتر نمیکند.
طبق گزارش CryptoSlate، کوینبیس در ۷ اکتبر نتایج ارزیابی خود برای سرویس Onramp را منتشر کرد. این ارزیابی شامل بازپخش ۱۶ هزار و ۱۴۰ تراکنش مربوط به ۷ هزار و ۲۹۳ کاربر بود و در میان آنها ۸۱۳ تراکنش بهطور قطعی تقلبی تشخیص داده شده بود. دادهها از دورهای ۹ هفتهای پیش از راهاندازی عامل ریسک کوینبیس انتخاب شدند؛ موارد کلاهبرداری قطعی که نتیجه آنها مشخص شده بود در مجموعه باقی ماندند و تراکنشهای قانونی بهصورت نمونهگیری وارد آزمون شدند.
در این چارچوب، هر مدل رفتار اخیر تراکنشها را با دستورالعملهای یکسان بررسی کرد. همچنین سیاستی که مشخص میکرد طبقهبندی ریسک چگونه به تصمیم عملیاتی تبدیل شود، تغییری نکرد. بنابراین هدف آزمون، مقایسه رفتار خود مدلها در یک تنظیم ثابت بود، نه مقایسه دو سامانه غربالگری کاملاً بازطراحیشده.
نتیجه بازپخش تاریخی چه بود؟
کوینبیس این جفتها را با هم مقایسه کرد: Opus 4.5 با Opus 5، Sonnet 4.6 با Sonnet 5 و GPT-5.4 با GPT-5.6 (sol). نسخه جدیدتر در هر سه خانواده، نرخ شناسایی کمتری داشت. این معیار که با عنوان recall شناخته میشود، سهم موارد کلاهبرداری را نشان میدهد که مدل توانسته است پیدا کند. معیار دیگری به نام dollar-weighted recall نیز سهم ارزش مالی کل کلاهبرداری را که شناسایی شده، اندازهگیری میکند.
در هر سه مقایسه، نسخه جدیدتر علاوه بر کاهش recall، امتیاز F1 پایینتری هم داشت. F1 ترکیبی از دقت و پوشش شناسایی است. dollar-weighted recall نیز در همه موارد کاهش یافت؛ یعنی مدلهای جدیدتر نهتنها تعداد کمتری از پروندههای تقلبی را گرفتند، بلکه بخش کوچکتری از ارزش مالی تقلب را هم شناسایی کردند.
افت Sonnet چشمگیرتر بود: recall آن ۲۲.۲ واحد درصد و dollar-weighted recall آن ۲۲.۹ واحد درصد کاهش داشت. recall مدل Opus نیز ۰.۸ واحد درصد پایین آمد. هر دو نسخه جدید Opus و Sonnet دقت کمتری داشتند؛ به این معنا که سهم کمتری از تراکنشهایی که بهعنوان تقلب علامتگذاری کرده بودند، واقعاً تقلبی بود.
نتیجه GPT نمونهای از خطر تمرکز بر یک شاخص منفرد بود. دقت این مدل ۱۱.۵ واحد درصد بهتر شد، اما recall آن ۲۰.۷ واحد درصد و dollar-weighted recall آن ۲۱.۸ واحد درصد افت کرد. بنابراین پرچمهای تقلبی مدل دقیقتر شده بودند، اما تعداد بیشتری از موارد تقلب و ارزش مالی آنها از شناسایی گریختند.
این بازپخش بهتنهایی ثابت نمیکند که استفاده از این نسخهها در عمل به زیان مشتریان منجر شده است. کوینبیس همچنین گفت که توانسته این افت عملکرد را شناسایی کند، اما علت آن را مشخص نکرده است. در نتیجه، دادههای منتشرشده درباره رابطه میان ارتقای نسخه مدل و نتیجه آزمون است، نه اندازهگیری زیان واقعی مشتریان.
مدل اختصاصی کوینبیس عملکرد متفاوتی داشت
کوینبیس در افشای اطلاعاتی در ۸ اکتبر، نتیجه جداگانهای درباره یک مدل سفارشی Qwen3.5-9B ارائه کرد. این مدل با استفاده از نتایج تاریخی کلاهبرداری و پاداشهای قطعی، بهگونهای تخصصی آموزش داده شده بود که میان نمونههای تقلبی و قانونی توازن برقرار کند. در ارزیابی جداگانه، مدل سفارشی در چهار معیار شناسایی تقلب از Opus 4.5 بهتر عمل کرد.
امتیاز F1 این مدل ۹.۶ واحد درصد بالاتر بود و dollar-weighted recall آن ۳۵.۴ واحد درصد افزایش یافت. این نتیجه با بازپخش مقایسه نسخههای عمومیتر یکسان نیست و نباید بهعنوان نقض مستقیم آن تلقی شود؛ زیرا مدل سفارشی و شیوه ارزیابی آن در یک آزمون جداگانه بررسی شدهاند.
اندازهگیریهای تولیدی نیز نشان دادند میانه تأخیر سراسری درخواستهای LLM برای مدل سفارشی ۰.۶۸۳ ثانیه بوده، در حالی که این رقم برای Opus 4.5 برابر با ۱.۵۱۵ ثانیه ثبت شده است. کوینبیس کاهش نسبی ۵۵ درصدی را گزارش کرد. این اندازهگیری سرعت، جدا از آزمون تشخیص تقلب انجام شده و بهتنهایی نشان نمیدهد کدام مدل در همه جنبههای عملیاتی برتر است.
چرا روش ارزیابی اهمیت دارد؟
برای ارائهدهندگان خدمات پرداخت، پرسش اصلی فقط این نیست که نسخه جدید یک مدل در یک معیار امتیاز بالاتری دارد یا نه. باید مشخص شود مدل در همان سیاست تصمیمگیری واقعی، چه سهمی از موارد تقلب و چه مقدار از ارزش مالی آن را پوشش میدهد. دقت، پوشش، سرعت، قابلیت اتکا و هزینه میتوانند همزمان تغییر کنند و بهبود یکی از آنها ممکن است افت دیگری را پنهان کند.
کوینبیس پیشتر نیز آزمایشی آنلاین درباره افزودن بررسی انتخابی توسط یک عامل زبانی انجام داده بود. در آن جریان، در مقایسه با استفاده از مدلها و قواعد موجود بدون عامل، تعداد تراکنشهای تقلبی ۳۰ درصد و ارزش تقلب ۲۲ درصد کمتر ثبت شد. با این حال، آن آزمایش نسخههای جدید مدل را با نسخههای قبلی مقایسه نمیکرد و با آزمون تاریخی اخیر یکسان نیست.
پژوهشگران SR-Fraud در توضیح محدودیتها گفتهاند مجموعه داده اختصاصی است و امکان انتشار آن وجود ندارد؛ بنابراین تکرار مستقل آزمون و تعمیم نتایج محدود میشود. در مجموع، یافتههای کوینبیس بر ضرورت آزمون هر ارتقا در پیکربندی واقعی تصمیمگیری تأکید دارد و سپس بررسی جداگانه تغییرات دستورها یا آستانههای تصمیم را پیشنهاد میکند.
تصویر فعلی بازار بر اساس دادههای Moneyiar
دادههای بازار Moneyiar در ۱۱ اکتبر ۲۰۲۶ نشان میدهد قیمت Cronos با نماد CRO برابر ۰.۰۵۹۴۲۷۶۷۹۴ دلار بوده و این دارایی در ۲۴ ساعت ۲.۳۹ درصد و در هفت روز ۱۳.۱۵ درصد کاهش داشته است. Decimal با نماد DEL در ۰.۳۹۹۲۲۴۷۶۷۲ دلار معامله شده؛ تغییر ۲۴ساعته آن مثبت ۳.۰۱ درصد و تغییر هفتروزهاش منفی ۱.۳۸ درصد بوده است.
در همین دادهها، قیمت AKEDO با نماد AKE برابر ۰.۰۲۶۱۲۲۴۷۵۹ دلار ثبت شده و این دارایی در ۲۴ ساعت ۴.۳۶ درصد و در هفت روز ۲۶.۳ درصد افت کرده است. BNB Attestation Service با نماد BAS نیز ۰.۰۲۱۹۴۳۶۳۹۳ دلار قیمت داشته و تغییر آن در ۲۴ ساعت منفی ۱.۱۵ درصد و در هفت روز منفی ۸.۷ درصد بوده است. زمان ثبت دادههای CRO و AKE ساعت ۱۱:۵۴ و دادههای DEL و BAS ساعت ۱۱:۵۳ به وقت +۰۳:۳۰ بوده است.




